






RAG-Quelleneingang
Geben Sie den Abrufsystemen einen klareren Kontext aus dem öffentlichen Web
Die RAG-Arbeit beginnt vor den Embeddings, dem Ranking oder der Antwortgenerierung. Die erste Entscheidung ist, ob die Quellseite überhaupt nützliche Inhalte produzieren kann: reiner Text, Markdown mit Überschriften und Links, HTML für benutzerdefiniertes Parsing oder JSON-Metadaten, die der Pipeline helfen, die Antwort zu verstehen.
ScraperFly konzentriert sich auf diese erste Meile. Holen Sie sich die öffentliche Seite, rendern Sie JavaScript, wenn der Inhalt im Browser erstellt wird, wählen Sie das leichteste Antwortformat, dem nachgelagerte Systeme vertrauen können, und halten Sie schlechte Seiten aus der Wissensdatenbank, bevor sie zu schlechten Antworten werden.
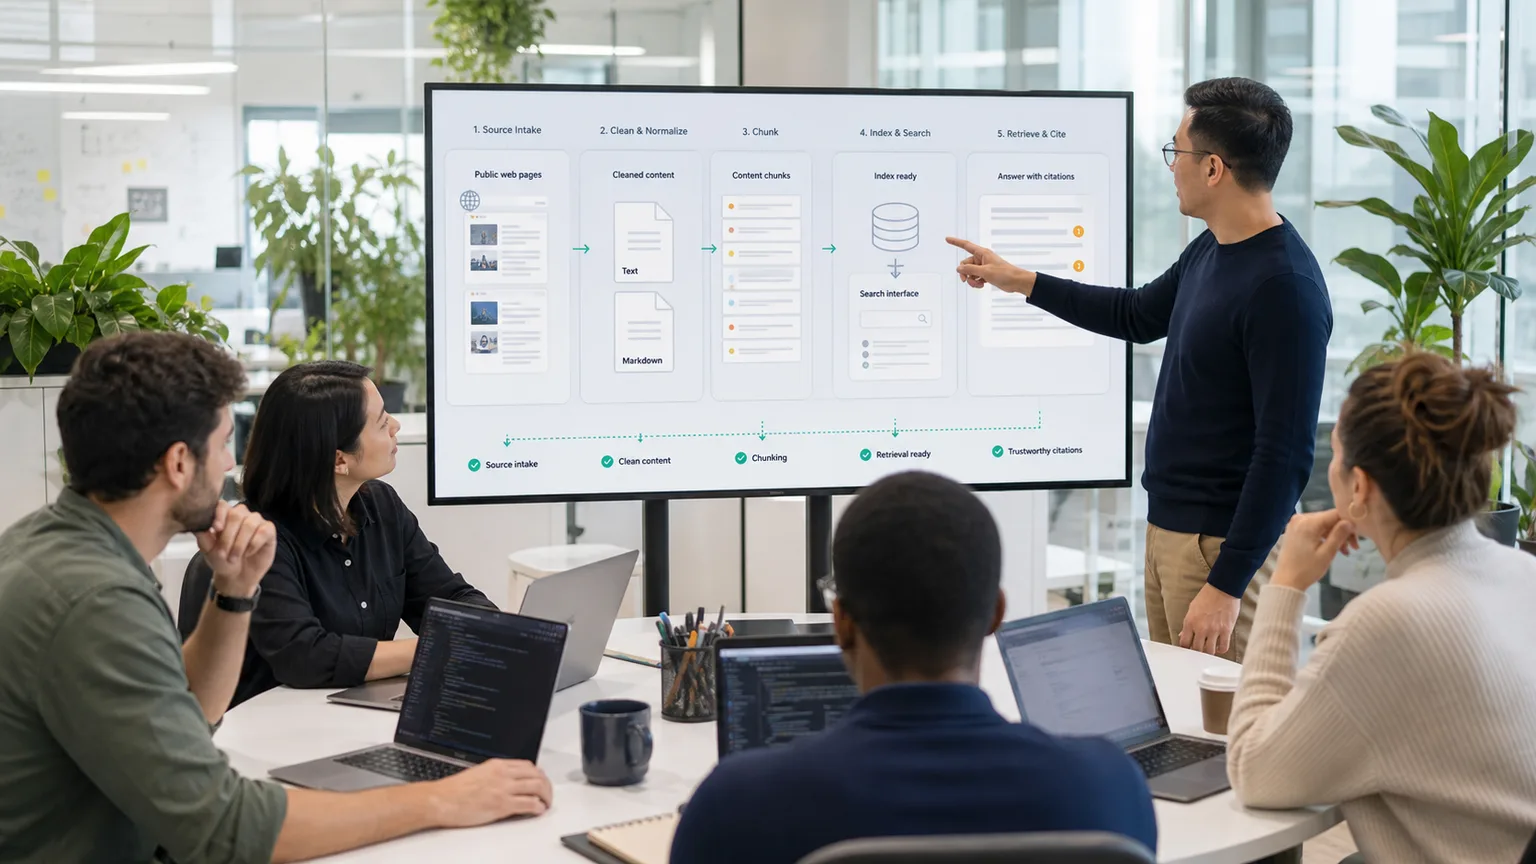
Was trägt eine Web Scraping API zu RAG bei?
Eine Web Scraping API liefert einem RAG-System das Quellmaterial, das es benötigt, bevor die KI-Schicht beginnt. Sie ruft öffentliche Seiten ab, verarbeitet die Anforderungsübermittlung, gibt ein Antwortformat zurück und bietet genügend Kontext, um zu entscheiden, ob die Seite für Chunking, Indizierung, Abruf und Zitation verwendbar ist.
Diese Rolle ist enger und praktischer als eine vollständige RAG-Plattform. ScraperFly muss keine Embeddings, Vektorspeicher, Abruf-Ranking oder Antwortgenerierung besitzen, um wertvoll zu sein. Es hilft Teams, diese Systeme mit saubereren Quellinhalten und besseren Anforderungsbeweisen zu versorgen.
Welches Antwortformat ist am besten für den RAG-Eingang?
Das beste Format hängt davon ab, was die Pipeline bewahren muss. Reiner Text ist kompakt und einfach zu chunking. Markdown behält nützliche Überschriften, Links, Listen und die Lesereihenfolge. HTML ist besser, wenn das System weiterhin Selektoren, Tabellen, DOM-Beziehungen oder benutzerdefinierte Extraktionen benötigt. JSON-Metadaten helfen, die endgültige URL, den Status, den Inhaltstyp, Überschriften, Links, Text und Markdown vor der Ausführung der Eingaberegeln zu überprüfen.
Die frühzeitige Wahl des Formats verhindert ein häufiges RAG-Problem: das Stopfen des Index mit Navigation, Fußzeilentext, wiederholtem Boilerplate, Cookie-Bannern, doppelten Karten und leeren Vorlagen. Das Ziel ist nicht, die größte Antwort zu scrapen. Das Ziel ist, die Quellform zu erfassen, die Ihr Abruf-Workflow tatsächlich nutzen kann.
| Format | Beste RAG-Nutzung | Worauf zu achten ist |
|---|---|---|
| Text | Einfaches Chunking, Suchindizierung, kompakter Kontext | Kann nützliche Struktur und Links entfernen |
| Markdown | LLM-bereite Quellüberprüfung, RAG-Chunks, dokumentationsähnliche Seiten | Benötigt weiterhin Duplikatsprüfung und Qualitätskontrollen |
| HTML | Benutzerdefiniertes Parsing, Selektoren, Tabellen, Metadaten, Linkextraktion | Kann Layoutgeräusche und Boilerplate enthalten |
| JSON-Metadaten | Diagnosen, Quelleninspektion, Eingabebeschlüsse | Ersetzt nicht die zielgruppenspezifische Extraktionslogik |
| Screenshot oder PDF | QA-Beweis und visuelle Überprüfung | Normalerweise nicht ideal als primäre Abrufquelle |
Wie sollten Teams die Quellenqualität vor der Indizierung validieren?
RAG-Pipelines scheitern leise, wenn schlechte Quellseiten in den Index gelangen. Eine erfolgreiche HTTP-Antwort kann immer noch nutzlos sein, wenn sie eine leere Hülle, eine Weiterleitung, eine Einwilligungswand, eine blockierte Seite, duplizierte Navigation oder eine Seite ist, auf der der wichtige Inhalt erst nach dem Ausführen von JavaScript erscheint.
Testen Sie vor der Skalierung der Eingabe repräsentative URLs. Vergleichen Sie das rohe HTML mit der gerenderten Ausgabe. Überprüfen Sie Text- und Markdown-Proben. Überprüfen Sie die endgültige URL, den Status, den Inhaltstyp, die Antwortgröße, die Überschriften, die Links, die wiederholten Abschnitte, die Daten und die Sprache. Bewahren Sie Beispiele akzeptierter und abgelehnter Seiten auf, damit die Eingaberegeln auf Beweisen und nicht auf Annahmen basieren.
| Qualitätsprüfung | Warum es wichtig ist | Nützliche ScraperFly-Ausgabe |
|---|---|---|
| Inhaltsvollständigkeit | Verhindert fehlende Antworten und schwache Zitationen | HTML, gerendertes HTML, Markdown, Text |
| Boilerplate-Geräusch | Reduziert irrelevante Chunks und wiederholten Kontext | Text, Markdown, JSON-Metadaten |
| Quellenidentität | Hilft bei Zitations- und Frischeentscheidungen | Endgültige URL, Status, Metadaten, Links |
| JavaScript-Abhängigkeit | Zeigt, ob das Rendern im Browser notwendig ist | Roh-HTML im Vergleich zur gerenderten Ausgabe |
Wann ist das Rendern von JavaScript für RAG wichtig?
Das Rendern ist wichtig, wenn der nützliche öffentliche Inhalt nicht in der ursprünglichen HTML-Antwort vorhanden ist. Viele moderne Seiten senden zuerst eine Hülle und laden dann Artikeltexte, Produktdetails, Kommentare, Dokumentationspanels oder Suchergebnisse, nachdem der Code auf der Browser-Seite ausgeführt wurde. Das Indizieren des Quell-HTML von diesen Seiten kann leere oder irreführende Kontexte erzeugen.
Der richtige Ansatz besteht darin, die Lücke nachzuweisen, bevor die Ausführung im Browser allgemein aktiviert wird. Beginnen Sie mit einer einfachen Anfrage, überprüfen Sie die Quellantwort und aktivieren Sie dann JavaScript-Rendering nur für Quellklassen, die es benötigen. Das hält statische Seiten kostengünstig, während dynamische Seiten einen klaren Weg in die RAG-Pipeline erhalten.
Wie passt ScraperFly in einen Produktions-RAG-Workflow?
ScraperFly passt in die Schicht des Quelleneingangs. Teams können es verwenden, um Ziel-URLs zu testen, Antwortformate auszuwählen, das Rendern bei Bedarf zu handhaben, den Anforderungskontext zu bewahren und Quellenbeweise zu sammeln, bevor der Inhalt in Chunking, Embeddings, Abruf, Ranking und Antwortgenerierung übergeht.
Verwenden Sie den API Builder, um Formate zu vergleichen, bevor Sie Eingabecode schreiben. Überprüfen Sie Web Scraping API-Antwortformate, um zwischen HTML, Text, Markdown, JSON, Screenshots und PDFs zu entscheiden. Für modellbereite Inhalte vergleichen Sie HTML zu Markdown und HTML zu Text Workflows und verwenden Sie dann Preise und den Kreditkostenrechner, bevor Sie die wiederkehrende Eingabe skalieren.










