






ScraperFlyAPI de datos web lista para IA

developer api

API de Parser de Contenido Web para captura de páginas públicas

ScraperFly ayuda a los equipos a capturar páginas web públicas en formatos de respuesta listos para el parser antes de que sus propios flujos de trabajo de extracción, IA, búsqueda, monitoreo, QA o archivo decidan qué significa el contenido.

Captura lista para el parser

Convierte páginas web públicas en entradas utilizables para el parser antes de construir la capa de extracción

Un parser de contenido web es tan bueno como la evidencia de página que recibe. Si el paso de captura devuelve una concha vacía, la región incorrecta, una redirección, un marcado ruidoso o un formato que el siguiente sistema no puede usar, el parser tiene que adivinar. Eso crea reglas frágiles, fallos confusos y trabajo de limpieza que debería haberse evitado antes.

ScraperFly proporciona a los equipos una capa de captura práctica antes de que comience el parsing. Obtén páginas públicas, renderiza JavaScript cuando el contenido útil se construye en el navegador, elige salida en HTML, texto, Markdown, metadatos, captura de pantalla o PDF, y pasa la evidencia más clara a tu propio parser, flujo de trabajo de IA, monitor, herramienta de QA o archivo.
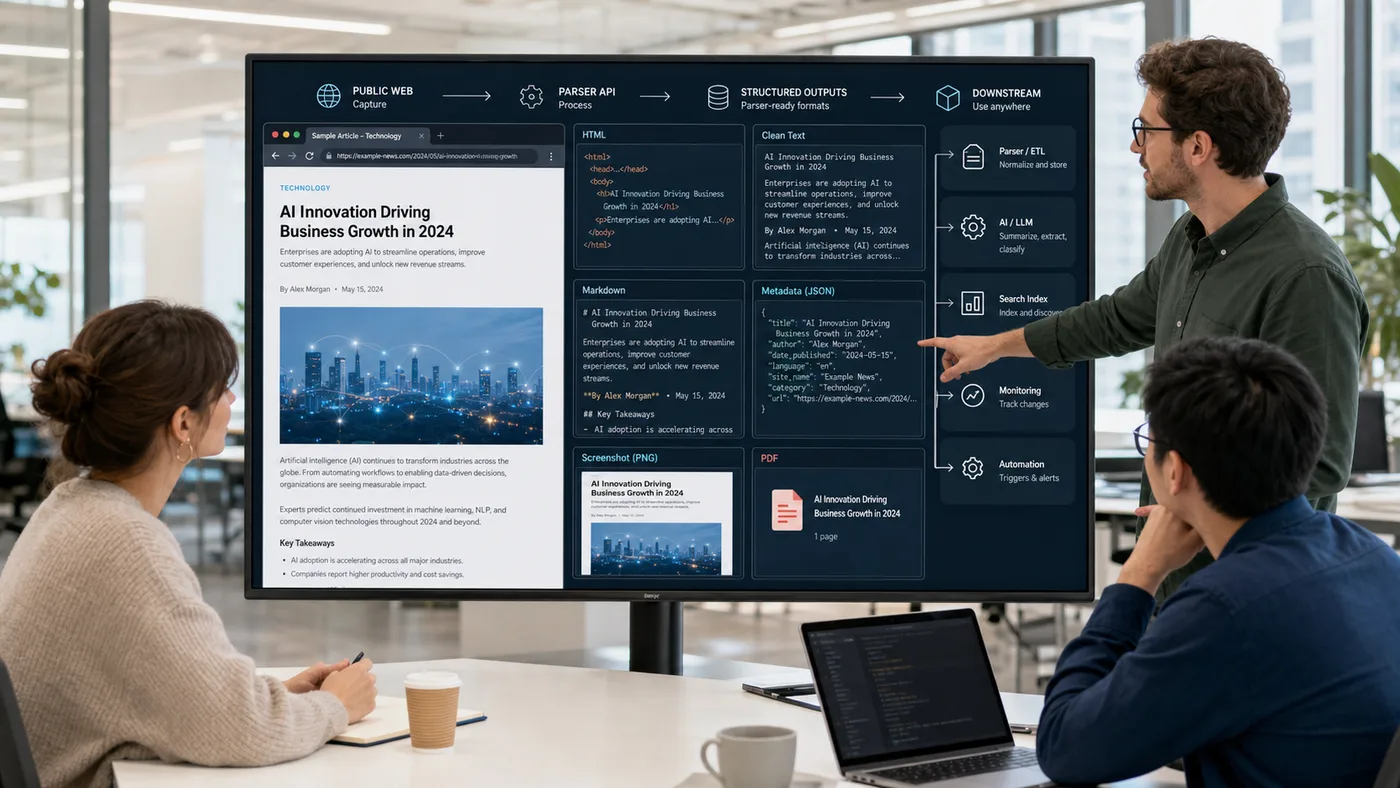
HTML Markdown metadatos prueba visual
Equipo revisando las salidas de captura de contenido web público para flujos de trabajo de parser y IA

¿Qué es una API de parser de contenido web?

Una API de parser de contenido web es un flujo de trabajo de solicitud que captura una página web pública y devuelve contenido en una forma que otro sistema puede inspeccionar, analizar, clasificar, resumir, monitorear o archivar. La respuesta puede ser HTML en bruto, HTML renderizado, texto limpio, Markdown, metadatos JSON, una captura de pantalla, un PDF o una combinación de salidas que se ajusten al trabajo posterior.

ScraperFly se centra en la capa de captura y formato de respuesta. Tu aplicación sigue siendo responsable de la extracción de campos, validación, modelos de contenido, clasificación, almacenamiento, deduplicación, alertas y lógica empresarial. Esa separación es útil porque las reglas de parsing son más fáciles de construir cuando el equipo ve primero evidencia confiable de la página.

Esta página es más amplia que una simple API de URL a texto y menos estrecha que una API de scraping de HTML. El punto es la elección del formato: da al parser, agente, índice de búsqueda, monitor o revisor la forma de respuesta que reduce el trabajo de limpieza y evita suposiciones prematuras.

Conclusión práctica: trata a ScraperFly como la capa de captura de páginas públicas, luego deja que tu propio parser decida cómo extraer y modelar el contenido.

¿Qué formato de respuesta debería alimentar a un parser de contenido?

El mejor formato de respuesta depende de lo que el parser necesita saber. HTML preserva selectores, atributos, enlaces, tablas y relaciones DOM. El texto limpio elimina el marcado cuando la legibilidad importa más que la estructura. Markdown mantiene encabezados, listas y enlaces en un formato compacto que funciona bien para revisión, documentación y entrada de IA. Los metadatos JSON dan contexto operativo alrededor de la solicitud. Las capturas de pantalla y los PDFs preservan la prueba visual.

Elegir el formato incorrecto crea fricción a posteriori. Enviar marcado en bruto a un resumidor puede añadir ruido. Enviar texto plano a un parser que necesita selectores puede eliminar contexto crucial. Generar capturas de pantalla para flujos de trabajo solo para máquinas añade peso sin mejorar la extracción. Un buen flujo de trabajo de captura prueba formatos antes de que la lógica del parser se convierta en código de producción.

SalidaÚsalo cuandoValor principalCompensación
HTML en brutoEl parser necesita selectores, atributos, enlaces, tablas o estructuraPreserva las relaciones de la páginaRequiere limpieza y parsing específico del objetivo
HTML renderizadoEl contenido útil aparece solo después de que se ejecuta JavaScript del lado del navegadorCaptura el estado de la página construida por el navegadorMás pesado que la captura de HTML fuente
TextoEl siguiente paso necesita contenido legible sin marcado de diseñoCompacto y fácil de buscar o clasificarElimina la mayor parte del contexto estructural
MarkdownLos flujos de trabajo de IA, RAG, revisión o documentación se benefician de encabezados y enlacesMantiene una estructura de lectura útilNo es ideal para extracción específica de DOM
Metadatos JSONLos registros, monitores y parsers necesitan contexto de solicitudMuestra estado, URL final, tipo de contenido, tiempo y tamañoNo reemplaza la extracción personalizada
Captura de pantalla o PDFLos flujos de trabajo de revisión, QA, cumplimiento o archivo necesitan evidencia visualPreserva la apariencia de la páginaMenos conveniente para el parsing automático

Utiliza la guía de formatos de respuesta cuando el equipo necesite una comparación más profunda antes de elegir una salida de producción.

¿Cuándo pertenece la renderización de JavaScript en un flujo de trabajo de parser?

La renderización es útil cuando el HTML fuente no es suficiente. Muchas páginas públicas envían una concha delgada, luego construyen cuerpos de artículos, tarjetas de productos, comentarios, tablas o estados de navegación después de que se ejecuta el código del lado del navegador. Un parser que solo ve la respuesta inicial puede perder completamente el contenido o construir reglas alrededor de marcadores de posición en lugar del estado real de la página.

La renderización aún debe ser deliberada. Comienza con HTML fuente, inspecciona la respuesta y habilita la API de renderización de JavaScript solo cuando la ejecución del navegador cambie el contenido útil. Eso mantiene los objetivos simples ligeros y reserva el trabajo más pesado del navegador para páginas que demuestran que lo necesitan.

Para los equipos de parser, la comparación más valiosa es la evidencia en bruto frente a la renderizada. Si ambas respuestas contienen el mismo contenido útil, mantén el perfil más barato. Si el HTML renderizado incluye los campos, tarjetas o contenido del cuerpo que el parser necesita, captura el estado renderizado y registra por qué ese control es parte del perfil fuente.

Conclusión práctica: haz de la renderización una decisión a nivel de fuente basada en la evidencia de respuesta, no una configuración predeterminada para cada solicitud de parser de contenido.

¿Cómo se adapta ScraperFly a la lógica de extracción personalizada?

ScraperFly captura páginas públicas y devuelve formatos de respuesta. No reemplaza tu modelo de extracción, diseño de esquema, coincidencia de entidades, clasificador, estrategia de rastreo, base de datos o flujo de trabajo editorial. Ese límite mantiene la plataforma honesta y le da a los equipos de ingeniería control sobre lo que significa el contenido dentro de su producto.

Un flujo de trabajo típico comienza con URLs públicas representativas en el API Builder. El equipo compara HTML fuente, HTML renderizado, texto, Markdown, metadatos, capturas de pantalla o PDFs. Una vez que se prueba la forma de respuesta, la aplicación escribe reglas de parser, plantillas de prompts, verificaciones de validación o lógica de monitoreo contra el formato que mejor se ajusta al trabajo.

Esto es especialmente útil para fuentes de contenido mixto. Un artículo de noticias, página de producto, página de documentación, listado de mercado, hilo de foro y página de reseñas pueden requerir diferentes lógicas de parsing. ScraperFly proporciona a esas fuentes una superficie de captura consistente mientras tu aplicación mantiene la inteligencia específica de la fuente.

¿Cómo pueden los equipos mantener el parsing de contenido web predecible?

Los proyectos de parsing se vuelven costosos cuando cada página recibe el perfil de solicitud más pesado antes de que el equipo sepa lo que necesita el objetivo. La renderización del navegador, el enrutamiento premium, las sesiones, las esperas, las capturas de pantalla y los PDFs tienen su lugar, pero deben estar vinculados a la evidencia.

DecisiónBuen predeterminadoEscalar cuando
Captura inicialComienza con HTML fuenteLa respuesta está vacía, incompleta o falta contenido útil
FormatoElige la salida utilizable más pequeñaEl parser o revisor a posteriori necesita más estructura o prueba
RenderizaciónMantén la ejecución del navegador desactivada por defectoJavaScript crea el contenido que el parser necesita
Archivos visualesOmitir para parsing solo de máquinaQA, auditoría, monitoreo o revisión humana necesita la apariencia de la página
Controles de enrutamientoUsa el camino normal primeroEstado, redirecciones, comportamiento regional o fallos de entrega muestran una necesidad

El modelo de precios de ScraperFly apoya este enfoque por etapas. Comienza con créditos gratuitos, prueba objetivos reales, usa pago por uso mientras la mezcla de fuentes es desigual y mueve la captura recurrente a créditos mensuales cuando se demuestre el volumen y el peso de la solicitud. La página de Precios ayuda a los equipos a conectar los controles de solicitud con el costo antes de escalar.


Conclusión práctica: el parsing predecible comienza con un perfil de captura ligero, evidencia de respuesta clara y formatos elegidos en torno al consumidor a posteriori.

Flujo de trabajo del parser

Construye la solicitud de captura antes de escribir la lógica del parser

Utiliza el API Builder para probar URLs públicas representativas, comparar salidas en bruto y renderizadas, elegir HTML, texto, Markdown, metadatos JSON, captura de pantalla o PDF, y copiar una forma de solicitud probada en tu parser, IA, monitoreo o flujo de trabajo de QA.

01
01

Preserva la estructura de la página

Utiliza HTML cuando los selectores, atributos, tablas, enlaces o relaciones DOM sean importantes para tu parser.

02
02

Reduce el ruido del contenido

Utiliza texto o Markdown cuando el sistema a posteriori necesite contenido legible en lugar de marcado en bruto.

03
03

Mantén la prueba visual

Utiliza capturas de pantalla o PDFs cuando los flujos de trabajo de QA, monitoreo, auditoría o revisión necesiten la apariencia de la página.

Controles de solicitud útiles para el parser

url

La página objetivo para obtener, renderizar, limpiar o capturar.

format

Selecciona la respuesta que tu producto necesita: html, texto, markdown, json, captura de pantalla o pdf.

premium

Escalar a enrutamiento más fuerte para bloques, objetivos inestables o contenido sensible a la geolocalización.

render

Ejecuta Chromium para SPAs, marcado inyectado por JS, capturas de pantalla, PDFs y páginas solo para navegador.

country

Solicita una ruta específica de país cuando el contenido cambia según la ubicación.

keep_headers

Reenvía el contexto de solicitud seleccionado, como user-agent, cookie, idioma y referer.

render_wait

Dale al contenido dinámico una espera controlada adicional antes de la extracción o captura.

download

Devuelve artefactos visuales como archivos descargables cuando la salida es captura de pantalla o PDF.

ejemplo de cURL

Genera Markdown con la misma forma de solicitud que puedes mover a producción

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Planificación del parser

Inspecciona la página objetivo antes de comprometerte con un modelo de extracción

Un parser debe construirse en torno a la respuesta que el objetivo realmente devuelve. Verifica si el HTML fuente contiene el contenido útil, si la renderización cambia el estado de la página, qué formato de salida necesita el sistema a posteriori y qué metadatos o prueba visual deben preservarse para depuración.

Respuesta HTML cruda mapeada a datos visibles de la página
01

Disponibilidad de HTML crudo

Verifica si los campos que necesitas ya están presentes en la primera respuesta HTML.

Mejor primera prueba para páginas simples, artículos, documentos, listados y detalles de productos.

Comparación antes y después de la renderización de JavaScript
02

Dependencia de JavaScript

Compara HTML crudo con el DOM renderizado o captura de pantalla antes de activar la renderización del navegador.

Usa la renderización cuando el HTML crudo es solo una estructura y los scripts crean el contenido útil.

Cookies, consentimiento, contexto de sesión y acceso para scraping
03

Estado y contexto de acceso

Identifica si las cookies, el consentimiento, los límites de inicio de sesión, la paginación o el mismo estado del visitante afectan la respuesta.

Usa sesiones y encabezados cuando la continuidad cambia los datos que recibes.

Variaciones de contenido regional a través de países y rutas
04

Variación geo/contenido

Prueba si el país, idioma, moneda, inventario, SERP, anuncios o la reputación de la ruta cambian el resultado.

Usa enrutamiento geo o premium solo cuando el objetivo demuestra que la respuesta varía según la ruta.

Preguntas antes de escalar el parsing de contenido

¿Dónde está el campo objetivo?

Encuentra si el campo existe en HTML crudo, DOM renderizado, una llamada API, datos estructurados, un archivo o un estado de interacción posterior.

¿Qué cambia la respuesta?

Muestra algunas URL y compara el estado, la URL final, la longitud del contenido, redirecciones, estados vacíos y diferencias en los resultados visibles.

¿Qué contexto se requiere?

Marca cualquier dependencia en consentimiento, localización, cookies, encabezados, límites de autenticación, paginación, filtros o solicitudes anteriores.

¿Cómo se ve el fallo?

Define las señales para respuestas bloqueadas, parciales, obsoletas, redirigidas, vacías, con tiempo de espera o desajustadas por región antes de escalar.

Configuración del objetivo del parser

Modo de obtención

La disponibilidad de HTML crudo decide si la primera solicitud puede permanecer simple o necesita renderizado, esperas, capturas de pantalla o extracción.

Contexto de la solicitud

Los requisitos de estado deciden si agregar encabezados, cookies, sesiones, manejo de consentimiento o un perfil de visitante estable.

Elección de enrutamiento

Los hallazgos geográficos y de reputación deciden si el enrutamiento estándar es suficiente o si se justifica una ruta de país/premium.

Reglas de validación

Los estados de fallo conocidos se convierten en verificaciones para reintentos, escalación, revisión de QA y decidir cuándo un perfil más ligero sigue siendo completo.

Mejores entradas para el parser.

Elige ScraperFly cuando necesites capturar evidencia antes de las suposiciones del parser.

Muchas herramientas de scraping facilitan la obtención de una URL, pero dificultan la decisión sobre qué forma de respuesta pertenece al parser. ScraperFly ofrece a los equipos un camino práctico: comienza gratis, inspecciona objetivos reales, mantiene las páginas simples ligeras, añade renderizado o enrutamiento solo cuando sea útil, y devuelve el formato que tu flujo de trabajo posterior puede usar de inmediato.

Equipo feliz validando un proyecto en una laptop
01 / Comienza fácil

Inicio fácil y gratuito antes de cualquier presión de facturación

ScraperFly te da espacio para probar el objetivo real primero. Usa créditos gratuitos para verificar si la página funciona, si los datos están presentes y qué controles son realmente necesarios antes de comprometer dinero a un plan. Eso hace que el primer experimento se sienta ligero: sin bucle de adquisición, sin suscripción forzada, sin adivinar tu volumen mensual desde el primer día.

Créditos gratuitosSin tarjeta para las primeras pruebasValida antes de escalar
Profesional sonriente trabajando con éxito en una laptop
02 / Gasta inteligentemente

Facturación asequible y flexible para el volumen de scraping del mundo real

No toda carga de trabajo de scraping es una curva mensual ordenada. Algunos proyectos aumentan, algunos se detienen y algunos solo se convierten en recurrentes después de que los datos demuestran su valor. ScraperFly apoya esa realidad con un camino de pago por uso más planes de crédito mensuales cuando el volumen constante tiene sentido. Puedes comprar lo que necesitas, mantener los costos visibles y evitar convertir una pequeña prueba en una suscripción sobredimensionada.

Pago por usoMensual cuando sea útilControl de costos
Desarrollador preparando salida estructurada desde una laptop
03 / Envía más rápido

Preprocesamiento de respuestas que elimina el trabajo de limpieza

Una obtención barata no es suficiente si tu equipo aún tiene que construir convertidores, limpiadores, capturas de pantalla, captura de PDF y formateo listo para LLM a su alrededor. ScraperFly puede devolver la respuesta como HTML, texto limpio, Markdown, JSON estructurado, PDF o salida de imagen, para que tu canal se acerque al activo final en una sola solicitud. Menos código de pegamento, menos partes móviles, entrega más rápida.

HTMLTextoMarkdownJSONPDFImagen

Dónde ScraperFly ayuda a los equipos de parsing de contenido.

Compara decisiones de captura en torno a la evidencia, elección de formato, peso de la solicitud y claridad de depuración en lugar de tratar cada página como la misma entrada del parser.

Punto de decisiónVentaja de ScraperFlyCompromiso típico de competidores
Primer experimentoComienza con créditos gratuitos y valida el objetivo real antes de gastar. Puedes comprobar si realmente se necesita HTML en bruto, renderización, enrutamiento premium o segmentación por país.Las pruebas a menudo te empujan rápidamente hacia un plan recurrente o ocultan el verdadero costo hasta que los complementos entran en la solicitud.
Modelo de facturaciónUtiliza créditos de pago por uso para trabajos irregulares, y luego pasa a créditos mensuales solo cuando la carga de trabajo se vuelve predecible. Esto mantiene las pruebas pequeñas y el scraping basado en proyectos asequible.Muchas herramientas están optimizadas en torno a suscripciones mensuales, asignaciones fijas o puertas de nivel que pueden sentirse pesadas antes de que se demuestre el volumen.
Peso de la solicitudMantén las páginas simples simples. Activa la renderización de JavaScript, el enrutamiento premium, las sesiones, los encabezados, las esperas o el enrutamiento por país solo cuando la evidencia de la respuesta indique que son importantes.Pueden existir controles comparables, pero a menudo están agrupados en niveles más altos, predeterminados o perfiles de precios más complejos.
Formatos de salidaDevuelve la respuesta en la forma que tu producto necesita: HTML para analizadores, texto o Markdown para tuberías de contenido, JSON para metadatos estructurados, y salida en PDF/imágenes para prueba visual.Algunos proveedores se centran principalmente en el acceso y dejan el formato, la captura, la limpieza y la preparación posterior a tu propio código.
Flujo de trabajo del desarrolladorUna superficie de API puede cubrir pruebas de objetivos, escalamiento, renderización, enrutamiento, sesiones, encabezados, formateo de respuestas y verificaciones de estado. El camino desde el prototipo hasta la producción se mantiene compacto.Las herramientas centradas en proxies, los mercados de actores y las plataformas de rastreo pueden ser poderosas, pero a menudo requieren más código de pegamento o un modelo operativo más pesado.
Mejor ajusteEquipos que desean entrega práctica de datos web: comienza pequeño, mide el costo por resultado útil y escala solo los controles que mejoran el resultado.Los equipos con contratos fijos de alto volumen, infraestructura de proxy personalizada o necesidades amplias de rastreo de mercado pueden preferir una plataforma más especializada.

Control de costos

Mantén el parsing de contenido asequible al igualar el peso de la solicitud con la evidencia.

No todas las entradas del parser necesitan renderizado en navegador, capturas de pantalla, PDFs, sesiones o entrega premium. ScraperFly apoya un camino escalonado: comienza con créditos gratis, valida páginas reales, utiliza pago por uso mientras las fuentes son desiguales, y mueve la captura recurrente a créditos mensuales cuando la mezcla de objetivos esté probada.

Una solicitud HTML ligera que devuelve una respuesta simple
01

Obtención básica

Utiliza una obtención básica cuando el HTML público ya contiene los campos que necesitas.

Perfil de solicitud más ligero; mantenlo cuando la respuesta esté completa.

Renderizado de JavaScript produciendo un DOM completo
02

Renderización

Utiliza el renderizado cuando el HTML en bruto es una estructura y JavaScript completa la página.

Perfil más pesado; úsalo solo cuando la salida del navegador cambie el resultado.

Varios requests preservando cookies y estado del visitante
03

Sesión con estado

Usa sesiones cuando las cookies, el consentimiento, la localidad o la paginación cambien la respuesta.

Perfil de estado más pesado; conservalo solo cuando la continuidad sea importante.

Enrutamiento de requests a través de rutas geo y de mayor calidad
04

Enrutamiento y geo premium

Usa enrutamiento premium o geo solo cuando el origen, país, reputación o contenido regional cambien el resultado.

Perfil de enrutamiento más pesado; aplícalo solo a objetivos que demuestren que lo necesitan.

Factores de costo de la solicitud del parser.

Más trabajo de infraestructura

El renderizado en el navegador, las opciones de enrutamiento y las esperas más largas significan que la plataforma tiene que hacer más que devolver una simple respuesta.

Más incertidumbre del objetivo

Redirecciones, estados vacíos, límites de tasa y páginas de desafío a menudo requieren opciones de entrega más fuertes o reintentos.

Más estado que preservar

Cookies, sesiones, consentimiento y flujos de múltiples páginas añaden partes móviles que una simple obtención sin estado no tiene.

Más evidencia para devolver

Capturas de pantalla, PDFs, salida renderizada y artefactos de respuesta más ricos son útiles, pero son más pesados que el HTML simple.

Controles que deberían ganarse su lugar

Muestra antes de escalar

Prueba primero un pequeño conjunto de URL y agrupa los objetivos por el perfil más ligero que devuelva datos completos.

No renderizar por defecto

Inspecciona el HTML crudo antes de activar el renderizado. Muchas páginas públicas ya contienen los datos que necesitas.

Escalar por evidencia

Aumenta solo cuando la respuesta muestre contenido faltante, dependencia de estado, variación geo o problemas de enrutamiento.

Mide resultados útiles

Optimiza en torno a registros válidos entregados, no al volumen de requests crudos. Un perfil más ligero es mejor solo cuando se mantiene completo.

Preguntas frecuentes sobre el analizador

Preguntas comunes sobre el parsing de contenido web con ScraperFly.

Respuestas prácticas para equipos que convierten páginas públicas en entradas listas para el parser sin sobreestimar la extracción automática, normalización de esquemas o lógica de rastreo.

Respuestas rápidas

Captura versus extracción

Dónde encaja ScraperFly en la pila del parser.

¿ScraperFly escribe mis reglas de analizador?

No. ScraperFly captura páginas públicas y devuelve formatos de respuesta. Tu aplicación posee las reglas de extracción, validación, normalización y almacenamiento.

¿Puede reemplazar un rastreador completo?

No. ScraperFly maneja la captura de solicitudes. La programación de rastreo, la estrategia de descubrimiento, la deduplicación y las alertas pertenecen a la parte posterior.

Eligiendo la entrada del analizador

Ajusta la forma de respuesta al consumidor.

¿Debería analizar HTML o Markdown?

Usa HTML cuando los selectores y la estructura importan. Usa Markdown cuando los encabezados, listas y enlaces legibles son mejores para la revisión o flujos de trabajo de IA.

¿Para qué son útiles los metadatos?

Los metadatos ayudan a los registros y monitores a entender el estado, la URL final, el tipo de contenido, el tiempo, el tamaño de la respuesta y el contexto de la solicitud.

Páginas de JavaScript

Utilice la ejecución del navegador solo cuando cambie el resultado.

¿Cuándo debo habilitar la renderización?

Habilita la representación cuando el contenido público útil está ausente del HTML fuente y aparece después de que se ejecuta JavaScript del lado del navegador.

¿Debería cada solicitud de parser renderizar?

No. Comienza con el HTML fuente y añade renderizado por objetivo cuando la evidencia de respuesta demuestre que es necesario.

Costo y fiabilidad

Mantén los perfiles de solicitud prácticos.

¿Cómo controlo los costos del parser?

Utiliza la salida más ligera que funcione, añade controles más pesados solo cuando mejoren la respuesta, y reserva capturas de pantalla o PDFs para registros que necesiten prueba.

¿Cómo debo depurar la entrada del parser que es mala?

Compara el estado, la URL final, el tipo de contenido, el tamaño de la respuesta, el HTML fuente, la salida renderizada y una muestra del formato devuelto antes de cambiar las reglas del parser.








