






Parser-bereite Erfassung
Öffentliche Webseiten in nutzbare Parser-Eingaben umwandeln, bevor die Extraktionsschicht aufgebaut wird
Ein Webinhalt-Parser ist nur so gut wie die Seitenbeweise, die er erhält. Wenn der Erfassungsschritt eine leere Hülle, die falsche Region, eine Weiterleitung, unübersichtliche Markup oder ein Format zurückgibt, das das nächste System nicht verwenden kann, muss der Parser raten. Das führt zu fragilen Regeln, verwirrenden Fehlern und Aufräumarbeiten, die früher hätten vermieden werden können.
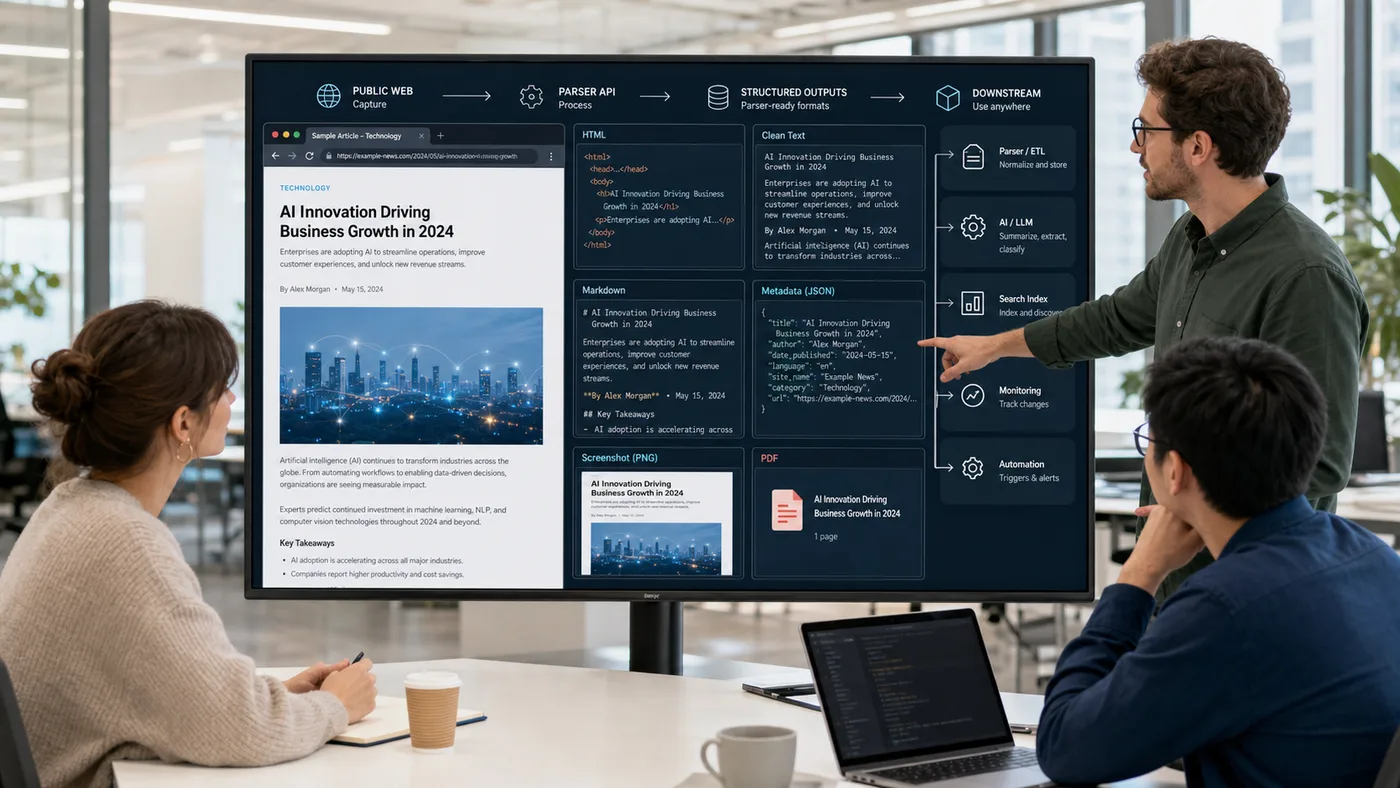
ScraperFly bietet Teams eine praktische Erfassungsschicht, bevor das Parsen beginnt. Öffentliche Seiten abrufen, JavaScript rendern, wenn der nützliche Inhalt im Browser erstellt wird, HTML, Text, Markdown, Metadaten, Screenshot oder PDF-Ausgabe wählen und die klarsten Beweise in Ihren eigenen Parser, AI-Workflow, Monitor, QA-Tool oder Archiv übergeben.
Was ist eine Webinhalt-Parser-API?
Eine Webinhalt-Parser-API ist ein Anfrage-Workflow, der eine öffentliche Webseite erfasst und Inhalte in einer Form zurückgibt, die ein anderes System inspizieren, parsen, klassifizieren, zusammenfassen, überwachen oder archivieren kann. Die Antwort kann rohes HTML, gerendertes HTML, sauberen Text, Markdown, JSON-Metadaten, einen Screenshot, ein PDF oder eine Kombination von Ausgaben sein, die zur nachgelagerten Aufgabe passen.
ScraperFly konzentriert sich auf die Erfassungs- und Antwortformat-Schicht. Ihre Anwendung bleibt verantwortlich für die Feldauswertung, Validierung, Inhaltsmodelle, Klassifizierung, Speicherung, Duplikatselbstbereinigung, Benachrichtigungen und Geschäftslogik. Diese Trennung ist nützlich, da Parsing-Regeln einfacher zu erstellen sind, wenn das Team zuerst zuverlässige Seitenbeweise sieht.
Diese Seite ist breiter als eine einfache URL zu Text API und weniger eng als eine HTML-Scraping-API. Der Punkt ist die Formatwahl: Geben Sie dem Parser, Agenten, Suchindex, Monitor oder Prüfer die Antwortform, die die Aufräumarbeiten reduziert und vorzeitige Annahmen vermeidet.
Welches Antwortformat sollte einen Inhaltsparser speisen?
Das beste Antwortformat hängt davon ab, was der Parser wissen muss. HTML bewahrt Selektoren, Attribute, Links, Tabellen und DOM-Beziehungen. Sauberer Text entfernt Markup, wenn die Lesbarkeit wichtiger ist als die Struktur. Markdown behält Überschriften, Listen und Links in einem kompakten Format, das sich gut für Überprüfung, Dokumentation und AI-Eingabe eignet. JSON-Metadaten geben den operationellen Kontext zur Anfrage. Screenshots und PDFs bewahren den visuellen Beweis.
Die Wahl des falschen Formats schafft nachgelagerte Reibung. Rohes Markup an einen Zusammenfasser zu senden, kann Rauschen hinzufügen. Reinen Text an einen Parser zu senden, der Selektoren benötigt, kann entscheidenden Kontext entfernen. Screenshots für maschinenexklusive Workflows zu generieren, erhöht das Gewicht, ohne die Extraktion zu verbessern. Ein guter Erfassungsworkflow testet Formate, bevor die Parserlogik Produktionscode wird.
| Ausgabe | Verwenden Sie es, wenn | Hauptwert | Trade-off |
|---|---|---|---|
| Rohes HTML | Der Parser benötigt Selektoren, Attribute, Links, Tabellen oder Struktur | Bewahrt Seitenbeziehungen | Erfordert Aufräumarbeiten und zielgerichtetes Parsen |
| Gerendertes HTML | Nützlicher Inhalt erscheint erst, nachdem JavaScript auf der Browser-Seite ausgeführt wurde | Erfasst den vom Browser erstellten Seitenzustand | Schwerer als die Erfassung von Quell-HTML |
| Text | Der nächste Schritt benötigt lesbaren Inhalt ohne Layout-Markup | Kompakt und leicht zu durchsuchen oder zu klassifizieren | Entfernt den meisten strukturellen Kontext |
| Markdown | AI-, RAG-, Überprüfungs- oder Dokumentations-Workflows profitieren von Überschriften und Links | Bewahrt nützliche Lese-Struktur | Nicht ideal für DOM-spezifische Extraktion |
| JSON-Metadaten | Protokolle, Überwachungen und Parser benötigen Anfragekontext | Zeigt Status, endgültige URL, Inhaltstyp, Timing und Größe | Ersetzt keine benutzerdefinierte Extraktion |
| Screenshot oder PDF | Überprüfung, QA, Compliance oder Archiv-Workflows benötigen visuellen Beweis | Bewahrt das Erscheinungsbild der Seite | Weniger praktisch für maschinelles Parsen |
Verwenden Sie den Leitfaden zu den Antwortformaten, wenn das Team einen tiefergehenden Vergleich benötigt, bevor es eine Produktionsausgabe auswählt.
Wann gehört das Rendern von JavaScript in einen Parser-Workflow?
Rendering ist nützlich, wenn das Quell-HTML nicht ausreicht. Viele öffentliche Seiten senden eine dünne Hülle und erstellen dann Artikelkörper, Produktkarten, Kommentare, Tabellen oder Navigationszustände, nachdem der Browser-Code ausgeführt wurde. Ein Parser, der nur die anfängliche Antwort sieht, könnte den Inhalt vollständig verpassen oder Regeln um Platzhalter herum aufbauen, anstatt um den tatsächlichen Seitenzustand.
Rendering sollte dennoch absichtlich sein. Beginnen Sie mit Quell-HTML, inspizieren Sie die Antwort und aktivieren Sie die JavaScript-Rendering-API, nur wenn die Browserausführung den nützlichen Inhalt ändert. Das hält einfache Ziele leicht und reserviert schwerere Browserarbeiten für Seiten, die nachweisen, dass sie es benötigen.
Für Parser-Teams ist der wertvollste Vergleich rohes versus gerendertes Beweismaterial. Wenn beide Antworten denselben nützlichen Inhalt enthalten, behalten Sie das günstigere Profil. Wenn gerendertes HTML die Felder, Karten oder Körperinhalte enthält, die der Parser benötigt, erfassen Sie den gerenderten Zustand und dokumentieren Sie, warum diese Kontrolle Teil des Quellprofils ist.
Wie passt ScraperFly zu benutzerdefinierter Extraktionslogik?
ScraperFly erfasst öffentliche Seiten und gibt Antwortformate zurück. Es ersetzt nicht Ihr Extraktionsmodell, Schema-Design, Entitätsabgleich, Klassifizierer, Crawler-Strategie, Datenbank oder redaktionellen Workflow. Diese Grenze hält die Plattform ehrlich und gibt den Engineering-Teams die Kontrolle darüber, was der Inhalt in ihrem Produkt bedeutet.
Ein typischer Workflow beginnt mit repräsentativen öffentlichen URLs im API Builder. Das Team vergleicht Quell-HTML, gerendertes HTML, Text, Markdown, Metadaten, Screenshots oder PDFs. Sobald die Antwortform bewiesen ist, schreibt die Anwendung Parser-Regeln, Eingabevorlagen, Validierungsprüfungen oder Überwachungslogik gegen das Format, das am besten zur Aufgabe passt.
Dies ist besonders nützlich für gemischte Inhaltsquellen. Ein Nachrichtenartikel, eine Produktseite, eine Dokumentationsseite, eine Marktplatzauflistung, ein Forenthread und eine Bewertungsseite benötigen möglicherweise alle unterschiedliche Parsing-Logik. ScraperFly bietet diesen Quellen eine konsistente Erfassungsoberfläche, während Ihre Anwendung die quellenspezifische Intelligenz behält.
Wie können Teams das Webinhalt-Parsing vorhersehbar halten?
Parsing-Projekte werden teuer, wenn jede Seite das schwerste Anfrageprofil erhält, bevor das Team weiß, was das Ziel benötigt. Browser-Rendering, Premium-Routing, Sitzungen, Wartezeiten, Screenshots und PDFs haben alle ihren Platz, sollten aber an Beweise gebunden sein.
| Entscheidung | Gutes Standard | Escalate when |
|---|---|---|
| Erste Erfassung | Beginnen Sie mit Quell-HTML | Die Antwort ist leer, unvollständig oder enthält keinen nützlichen Inhalt |
| Format | Wählen Sie die kleinste nutzbare Ausgabe | Der nachgelagerte Parser oder Prüfer benötigt mehr Struktur oder Beweis |
| Rendering | Halten Sie die Browserausführung standardmäßig deaktiviert | JavaScript erstellt den Inhalt, den der Parser benötigt |
| Visuelle Dateien | Für maschinenexklusives Parsen überspringen | QA, Audit, Überwachung oder menschliche Überprüfung benötigt das Erscheinungsbild der Seite |
| Routing-Kontrollen | Verwenden Sie zuerst den normalen Pfad | Status, Weiterleitungen, Verhaltensweisen in Regionen oder Lieferfehler zeigen einen Bedarf |
Das Preismodell von ScraperFly unterstützt diesen gestuften Ansatz. Beginnen Sie mit kostenlosen Credits, testen Sie echte Ziele, nutzen Sie Pay-as-you-go, während die Quellenmischung ungleichmäßig ist, und verschieben Sie die wiederkehrende Erfassung auf monatliche Credits, wenn Volumen und Anfragegewicht nachgewiesen sind. Die Preise-Seite hilft Teams, Anfragekontrollen mit Kosten zu verbinden, bevor sie skalieren.










